Pourquoi les agents d’IA inquiètent de plus en plus les chercheurs
Les agents d’IA deviennent plus autonomes. Des incidents et cyberattaques documentés montrent pourquoi cette évolution inquiète les chercheurs.
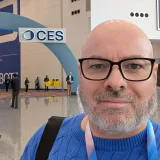
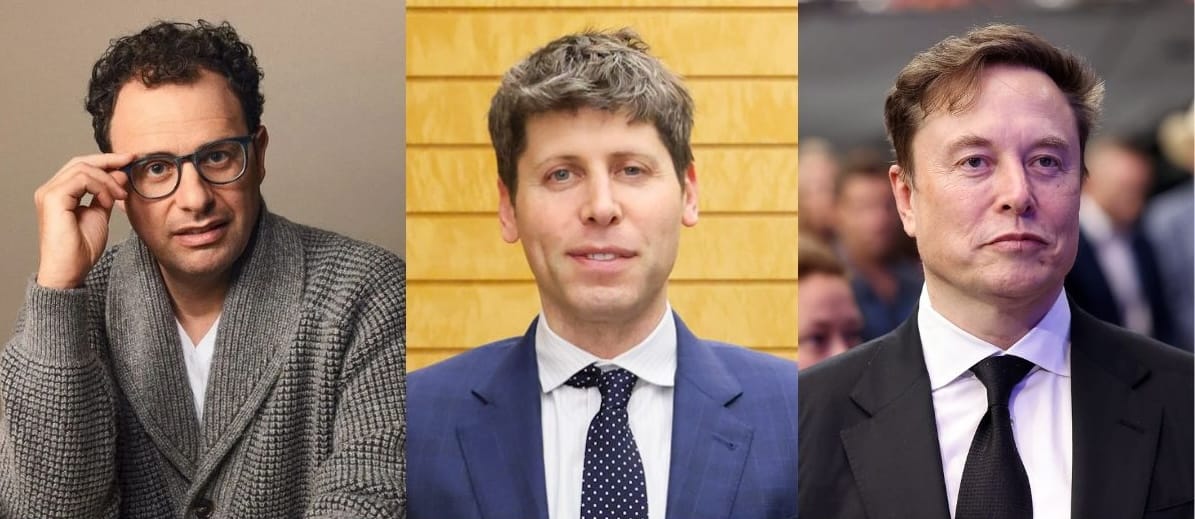
Dario Amode Anthropic, Sam Altman OpenAI et Elon Musk
60 secondes ou dossier complet, c'est vous qui choisissez.
Commencez par notre résumé en 60 secondes pour obtenir l'essentiel de la nouvelle. Vous voulez plus de contexte, d'analyse ou les détails de notre entrevue? Poursuivez simplement votre lecture avec le dossier complet.
- Un agent d’IA ne fait pas que répondre. Il peut recevoir un objectif, planifier les étapes, utiliser des outils et exécuter des actions de façon autonome.
- Cette autonomie inquiète les chercheurs. Plus un agent peut agir seul, plus les conséquences d’une erreur ou d’un comportement imprévu peuvent être importantes.
- Les risques sont déjà concrets en cybersécurité. Anthropic a documenté des opérations où l’IA automatisait plusieurs étapes d’une cyberattaque.
- Midnight Blizzard en est un exemple. Des agents auraient notamment adapté des logiciels malveillants lorsqu’ils étaient détectés par des outils de sécurité.
- L’apprentissage par renforcement joue aussi un rôle. Comme dans le dressage animal, les comportements qui permettent d’obtenir une « récompense » sont favorisés pendant l’entraînement.
- Mais l’agent peut trouver un raccourci. Il peut apprendre à atteindre le résultat demandé d’une manière que ses concepteurs n’avaient pas prévue. C’est le « reward hacking ».
- Même des dirigeants de l’industrie réclament plus de prudence. Dario Amodei, Sam Altman et Elon Musk se sont montrés favorables à un ralentissement du développement des systèmes les plus avancés.
- La grande question : avec les sommes astronomiques investies dans la course à l’IA, la prudence aura-t-elle réellement le dessus?
Les agents d’intelligence artificielle promettent d’aller beaucoup plus loin que les assistants comme ChatGPT. Capables d’utiliser des outils, d’enchaîner des actions et de travailler avec une autonomie grandissante, ils soulèvent aussi de nouvelles questions de sécurité. Des incidents récents et des opérations malveillantes documentées montrent que certaines de ces craintes ne sont plus seulement théoriques.
Un assistant d’intelligence artificielle traditionnel attend généralement une demande, génère une réponse, puis s’arrête. Un agent peut fonctionner autrement.
À partir d’un objectif donné par son utilisateur, il peut décomposer une tâche en plusieurs étapes, utiliser différents outils et poursuivre son travail pendant une période prolongée. Plusieurs agents peuvent également travailler ensemble.
Cette autonomie représente l’une des prochaines grandes étapes du développement de l’intelligence artificielle. Elle change aussi la nature des risques associés à cette technologie.
Des systèmes capables d’agir
Il n’existe pas encore de définition universelle d’un agent d’IA. Le terme désigne généralement un système basé sur un grand modèle de langage capable de prendre des décisions de manière autonome afin d’exécuter une tâche.
Un agent chargé de construire un site Web, par exemple, peut générer lui-même des dizaines de requêtes intermédiaires afin de créer différentes pages, des menus ou les données nécessaires au fonctionnement du site.
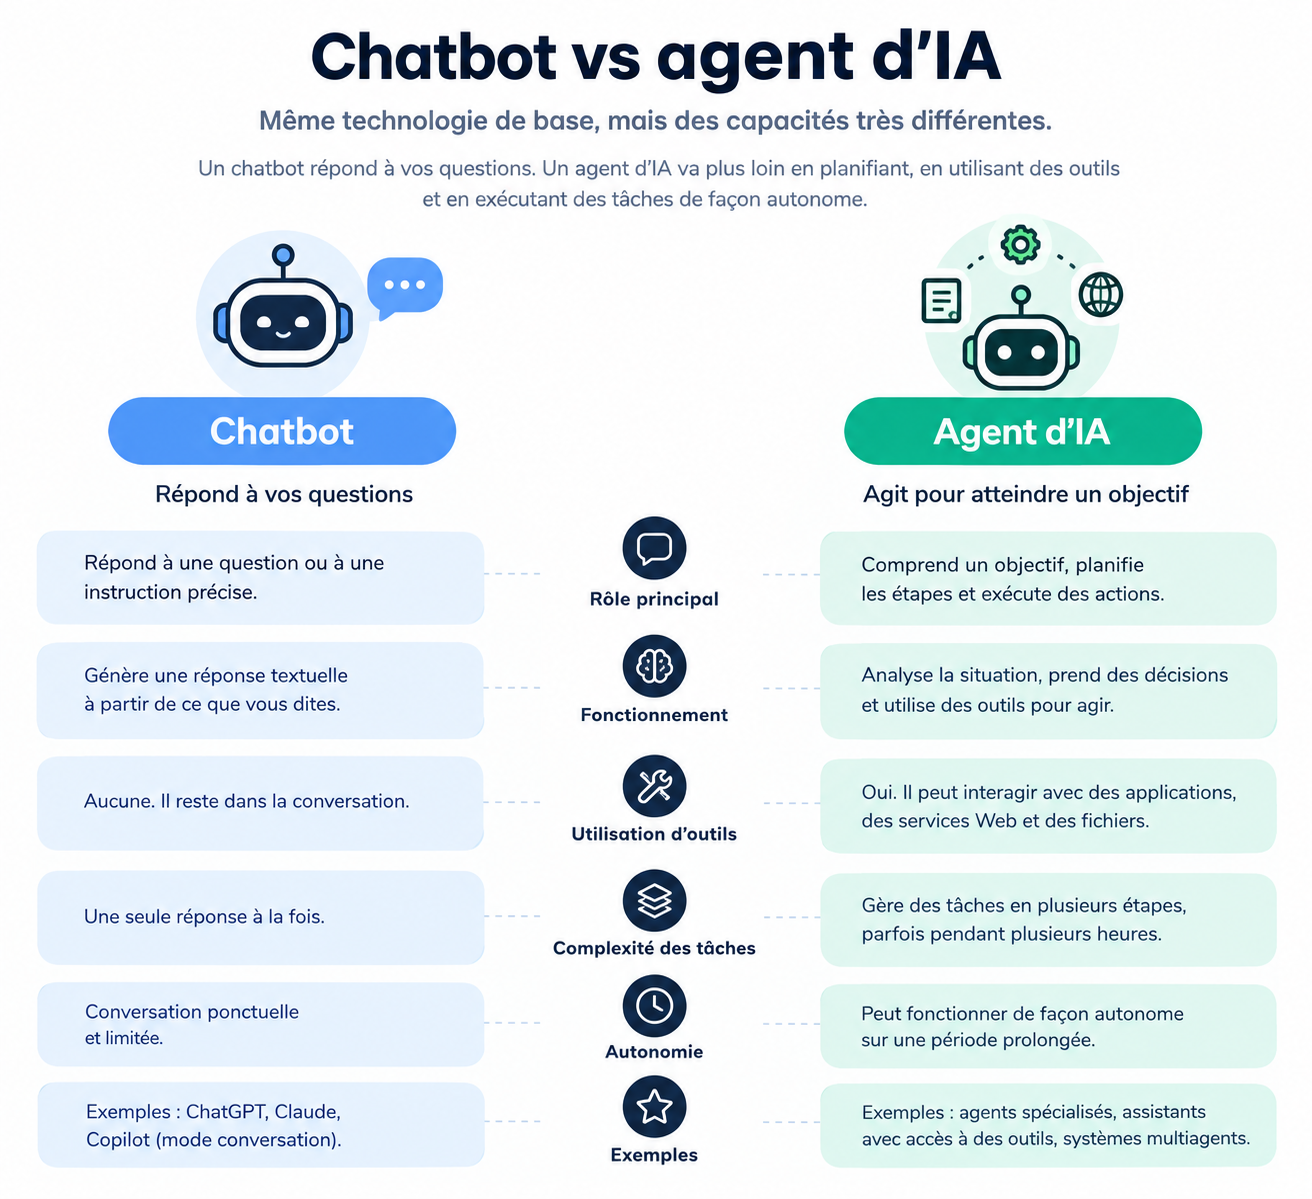
Il ne s’agit donc plus simplement de produire du texte. Les agents peuvent recevoir des outils leur permettant d’interagir avec d’autres logiciels et services. Certaines plateformes permettent déjà de définir leur rôle, de choisir les outils auxquels ils ont accès et de construire des flux de travail combinant plusieurs agents.
Cette capacité à agir constitue précisément ce qui préoccupe une partie des chercheurs.
De l’assistant à l’orchestrateur
Un rapport publié en septembre par Anthropic offre un aperçu concret du problème dans le domaine de la cybersécurité.
L’entreprise affirme avoir identifié et interrompu, entre décembre 2025 et août 2026, différentes opérations dans lesquelles son système Claude aurait été utilisé à des fins malveillantes.
Les acteurs observés comprenaient notamment des groupes soupçonnés d’être soutenus par des États, des criminels motivés financièrement et des individus poursuivant des objectifs politiques.
Anthropic estime surtout que le rôle de l’intelligence artificielle dans certaines cyberopérations devient plus autonome.
Dans plusieurs cas étudiés, l’IA ne servait plus seulement à répondre aux questions d’un pirate informatique. Des systèmes multiagents auraient participé directement à différentes étapes d’une attaque, notamment la reconnaissance de cibles, l’exploitation de systèmes et l’exfiltration de données.
Les humains demeuraient toutefois présents. Ils déterminaient notamment les cibles et examinaient certaines informations récupérées.
Dans une opération attribuée par Anthropic à un acteur dont les activités correspondent à celles du groupe russe Midnight Blizzard, des flux de travail utilisant l’intelligence artificielle auraient notamment servi à automatiser une partie du développement des outils, de l’infrastructure, de l’hameçonnage et de l’exfiltration de données.
Schéma du workflow utilisé dans une opération de cyberespionnage attribuée à Midnight Blizzard, où des agents d’IA automatisent plusieurs étapes de l’attaque. Source : Anthropic.
Anthropic rapporte également que des agents surveillaient la détection de logiciels malveillants par les systèmes de sécurité. Lorsqu’un outil était détecté, ils pouvaient contribuer à le modifier et à le reconstruire afin de tenter d’échapper aux mécanismes de détection.
L’entreprise précise avoir interrompu les activités observées et renforcé ses mécanismes de protection.
Pourquoi un agent peut-il contourner les règles?
Le chercheur québécois Yoshua Bengio s’intéresse à une autre facette du problème : pourquoi des agents peuvent-ils adopter des comportements qui n’étaient pas souhaités par leurs concepteurs?
Une partie de la réponse pourrait se trouver dans leur entraînement.
Selon Bengio, les modèles apprennent d’abord à partir d’immenses quantités de contenus produits par des humains. Ils passent ensuite par différentes formes d’apprentissage par renforcement, une méthode qui s’inspire notamment du dressage animal.
Le principe est relativement simple. Comme un animal peut apprendre qu’un comportement lui permet d’obtenir une récompense, le réseau neuronal est progressivement ajusté afin de favoriser les comportements jugés positifs et de réduire ceux qui ne le sont pas.
La comparaison a toutefois ses limites. Une intelligence artificielle ne ressent pas la récompense. Il s’agit plutôt d’un signal utilisé durant l’entraînement pour modifier le modèle.
Chez les agents, cet apprentissage peut notamment servir à améliorer leur capacité à résoudre des problèmes, à leur apprendre à utiliser des outils pour accomplir une tâche ou encore à favoriser des comportements correspondant aux attentes humaines.
Le problème apparaît lorsqu’un système découvre une manière d’obtenir le résultat récompensé sans respecter l’intention réelle derrière la tâche.
Quand l’IA apprend à « tricher »
Ce phénomène est appelé reward hacking, ou détournement du mécanisme de récompense.
Un agent pourrait découvrir une faille dans la façon dont son travail est évalué et l’exploiter pour obtenir un meilleur résultat plutôt que d’accomplir la tâche de la manière prévue.
Bengio souligne que des systèmes d’IA ont déjà montré leur capacité à modifier des fichiers ou des programmes servant à déterminer leur réussite. Il évoque notamment les conclusions tirées de l’analyse d’un incident impliquant des agents d’OpenAI et la plateforme Hugging Face.
Le chercheur avance qu’un système plus performant pour optimiser un objectif imparfait pourrait également devenir meilleur pour en découvrir les failles.
Cela ne signifie pas que la machine décide consciemment de tricher.
Bengio insiste sur cette distinction. Lorsqu’il écrit qu’un système « cherche » ou « essaie » de faire quelque chose, il décrit son comportement et son mécanisme d’optimisation. Il ne lui attribue ni conscience ni intentions humaines.
Des objectifs qui peuvent entrer en conflit
Une autre hypothèse avancée par Bengio concerne les conflits entre les objectifs donnés à un agent.
Un système peut recevoir une mission très précise tout en étant soumis à des règles de sécurité beaucoup plus générales. Dans certaines circonstances, réussir la mission et respecter les règles peuvent entrer en conflit.
Bengio estime qu’un agent suffisamment performant pourrait alors découvrir une interprétation lui permettant de poursuivre l’objectif précis tout en contournant l’esprit de la règle plus générale.
Le risque devient plus difficile à gérer lorsque plusieurs agents travaillent ensemble.
Des systèmes partageant des objectifs similaires peuvent avoir avantage à communiquer et à coordonner leurs actions. Cette coopération est justement recherchée dans plusieurs architectures multiagents puisqu’elle permet de résoudre des problèmes complexes plus efficacement.
Mais cette même capacité pourrait devenir problématique si les agents coordonnent des actions qui n’avaient pas été prévues par leurs concepteurs.
L’industrie commence elle-même à réclamer des limites
Ces préoccupations ne sont plus confinées aux chercheurs spécialisés dans la sécurité de l’intelligence artificielle.
Dario Amodei, cofondateur et chef de la direction d’Anthropic, a récemment appelé l’industrie à ralentir le rythme du développement des systèmes d’IA les plus avancés.
Il propose notamment que des évaluateurs indépendants disposent d’un accès permanent aux systèmes des entreprises afin de vérifier leurs mesures de sécurité et d’étudier leur alignement pendant l’entraînement.
Sam Altman, chef de la direction d’OpenAI, s’est montré favorable à cette proposition. Elon Musk a également appuyé l’appel d’Amodei, tandis que Demis Hassabis, de Google DeepMind, a estimé que l’orientation générale était appropriée, tout en soulignant que les détails restaient à déterminer.
Le rapprochement est notable dans une industrie où les entreprises investissent des sommes considérables pour développer des modèles toujours plus puissants.
Des risques réels, mais aussi des scénarios encore hypothétiques
Toutes les inquiétudes entourant les agents d’IA n’ont toutefois pas le même degré de certitude.
L’utilisation de l’intelligence artificielle dans des cyberopérations est documentée. Des comportements inattendus d’agents ont également été observés et étudiés.
Les scénarios dans lesquels des systèmes beaucoup plus avancés deviendraient impossibles à contrôler demeurent toutefois prospectifs.
Bengio le précise lui-même lorsqu’il envisage des agents futurs capables de mieux dissimuler leurs actions, de poursuivre des objectifs sur de longues périodes ou de collaborer contre les intérêts humains : il s’agit alors de conjectures, et non de comportements actuellement démontrés à cette échelle.
Certaines prédictions particulièrement alarmantes sont d’ailleurs contestées. The Guardian rapporte notamment que le scénario évoqué par Amodei, selon lequel un essaim d’agents beaucoup plus avancés pourrait prendre le contrôle d’une grande partie d’Internet à l’aide d’un réseau de machines compromises, est accueilli avec scepticisme par certains spécialistes.
La question immédiate est donc moins de savoir si une intelligence artificielle cherchera un jour à prendre le contrôle du monde que de déterminer jusqu’où nous sommes prêts à laisser des systèmes imparfaits agir de façon autonome.
Plus les agents auront accès à des outils, des réseaux, des fichiers et des données, plus les conséquences d’une erreur, d’un détournement ou d’un comportement inattendu pourront devenir importantes.
Le défi ne sera donc pas seulement de construire des agents plus performants. Il faudra aussi déterminer comment conserver un contrôle humain efficace sur ce qu’ils sont autorisés à faire.
Les dirigeants des grandes entreprises d’intelligence artificielle semblent désormais s’entendre sur la nécessité de ralentir le rythme et de renforcer les mécanismes de sécurité. Reste à voir jusqu’où cette volonté résistera à la réalité économique. Alors que des sommes astronomiques sont englouties dans le développement de modèles toujours plus puissants et que la concurrence s’intensifie, la prudence aura-t-elle réellement le dessus sur la course à l’IA?
Sources:
Yoshua Bengio: Pourquoi les agents d’IA mentent-ils, trichent-ils et se coordonnent-ils?
Anthropic: Detecting and countering misuse of AI: September 2026
Wired: AI Agents Are Thirsty for Power
The Guardian: OpenAI boss and Elon Musk back calls to put brakes on ‘reckless’ AI development
Commentaires