Mila et Mozilla investissent dans une infrastructure d’IA ouverte au Canada
Mila et Mozilla lancent à ALL IN une infrastructure d’IA ouverte, avec 6 millions de dollars engagés par Mozilla et Hypertec.
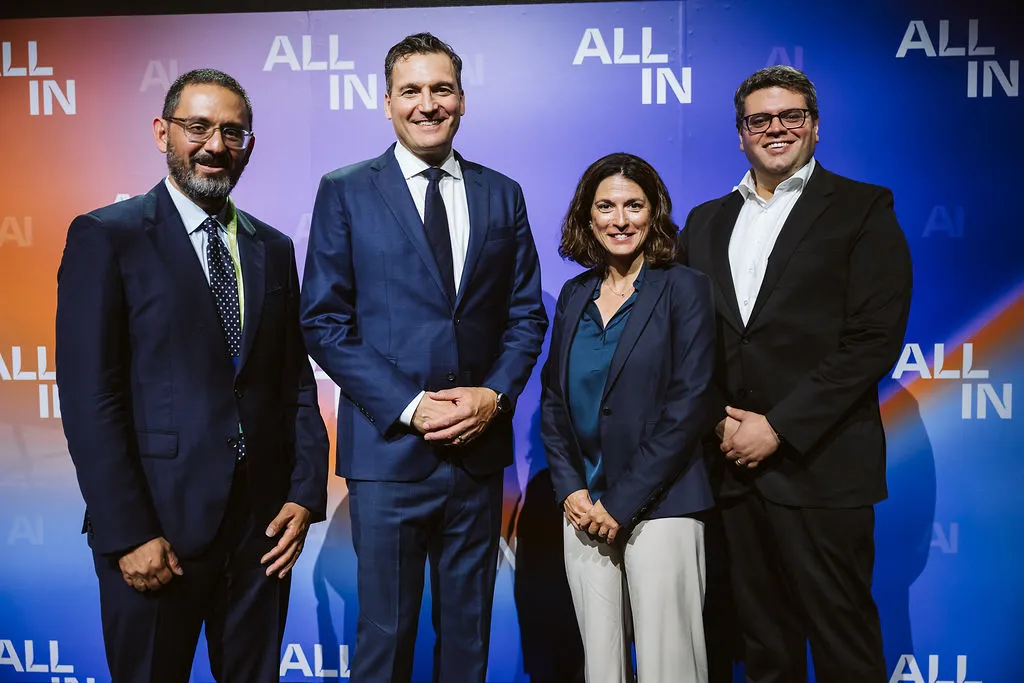
(Credit Photo All In Melanie Olmstead)
Mila et Mozilla veulent faciliter le déploiement d’intelligence artificielle ouverte directement dans les infrastructures des entreprises et des institutions. Annoncée à Montréal dans le cadre de ALL IN, l’initiative démarre avec un investissement de 5 millions de dollars de Mozilla, auquel Hypertec ajoutera 1 million de dollars pour la première année.
Le gouvernement du Canada a également annoncé son appui au projet, sans toutefois préciser dans le communiqué s’il s’accompagne d’un financement fédéral.
L’objectif est de développer une couche de fondation d’IA ouverte qui permettrait aux organisations d’exploiter des systèmes avancés sur leurs propres infrastructures, plutôt que de dépendre entièrement de services d’IA propriétaires hébergés dans le nuage.
Mila dirigera la réalisation technique et la coordination du projet. Mozilla apportera notamment son expertise dans les infrastructures ouvertes, tandis qu’Hypertec participera aux premiers déploiements canadiens sur son matériel.
Garder les données et l’IA à l’interne
Le projet tente de résoudre un problème auquel font face les organisations qui souhaitent utiliser des modèles d’IA ouverts.
Télécharger un modèle est relativement simple. Le transformer en un système utilisable en production, avec les contrôles d’accès, la sécurité, l’intégration aux systèmes existants et la gouvernance nécessaires, demande toutefois des ressources techniques importantes.
Mila et Mozilla veulent donc développer une infrastructure permettant de réduire cette complexité.
Une entreprise pourrait, par exemple, installer un assistant d’IA privé capable de consulter ses manuels, ses procédures et ses anciens dossiers de projets. Le système pourrait aussi aider les employés à produire des rapports, répondre à des questions techniques ou assister des développeurs dans l’écriture de code.
L’élément important est que les données pourraient demeurer dans l’environnement informatique choisi par l’organisation.
Cette approche pourrait intéresser notamment les entreprises et les institutions qui ne veulent pas transmettre certaines données à un fournisseur externe ou payer un service commercial pour chaque requête effectuée par leurs employés.
Une norme ouverte et une implémentation de référence
Le projet comportera deux grandes composantes.
La première sera une norme ouverte reposant sur des contrats d’interface. L’idée est de permettre le remplacement des différentes composantes de la pile technologique sans devoir reconstruire l’ensemble du système.
La seconde sera une implémentation de référence fonctionnelle qu’une organisation pourra installer sur ses propres machines ou sur l’infrastructure de son choix.
Cette implémentation doit permettre aux organisations de choisir leurs modèles et leurs mécanismes de contrôle, tout en intégrant la gouvernance et la gestion des accès.
Il ne s’agit donc pas de créer un nouveau modèle d’intelligence artificielle destiné à concurrencer directement les modèles commerciaux existants. Mila et Mozilla cherchent plutôt à construire l’infrastructure permettant d’assembler, déployer et exploiter plus facilement des technologies d’IA ouvertes.
Six mois de travail avant l’annonce
Le projet n’en est pas à son point de départ.
Mila et Mozilla indiquent travailler depuis six mois sur son architecture. Les deux organisations ont notamment évalué différentes composantes ouvertes et testé leur fonctionnement dans un système complet.
Les prochaines étapes devraient maintenant mener à des utilisations concrètes.
Mozilla et Mila prévoient publier d’ici six mois des implémentations de référence fonctionnelles destinées notamment aux entreprises, aux gouvernements et à des usages d’intérêt public.
Hypertec doit de son côté contribuer au passage de la recherche vers des déploiements dans des entreprises et institutions canadiennes.
Une question de contrôle technologique
L’initiative s’inscrit aussi dans le débat sur la souveraineté technologique et la dépendance envers les grandes plateformes étrangères d’intelligence artificielle.
« Le Canada a un choix à faire : dépendre de technologies développées ailleurs, ou bâtir davantage de ce dont nous avons besoin ici, chez nous », a déclaré Evan Solomon, ministre de l’Intelligence artificielle et de l’Innovation numérique.
Selon Valérie Pisano, présidente et cheffe de la direction de Mila, l’objectif est notamment de permettre aux organisations de « posséder leur avenir technologique » en leur donnant les moyens d’exploiter, contrôler et entretenir elles-mêmes leurs modèles d’IA.
Mozilla présente pour sa part le projet comme une façon de construire un écosystème dans lequel différentes technologies ouvertes peuvent fonctionner ensemble.
Cette volonté se heurte toutefois à un problème très concret : faire fonctionner de l’IA ouverte en production demeure difficile.
Mozilla affirme dans son rapport State of Open Source AI que 79 % des développeurs qui intègrent des fonctions d’intelligence artificielle utilisent des modèles ouverts, mais que seulement 53 % des équipes parviennent à passer à la production. Le rapport identifie notamment les coûts, la sécurité, l’intégration et la maintenance parmi les obstacles.
C’est précisément cette couche technique entre les modèles ouverts et leur utilisation quotidienne que Mila et Mozilla veulent simplifier.
Les premières implémentations de référence doivent être publiées dans les six prochains mois. Mila et Mozilla cherchent également d’autres entreprises, établissements de recherche, gouvernements, développeurs et bailleurs de fonds pour participer au projet.
Commentaires